13. novembre 2026
5 Minutes

Quand la machine apprend à piloter une allocation d’actifs : le reinforcement learning dans la gestion de patrimoine

Dans le cadre d’un projet d’innovation soutenu par Innosuisse, OLZ AG et la Haute école de Lucerne ont examiné si un modèle informatique apprenant peut répartir un portefeuille entre différentes classes d’actifs mieux que les méthodes classiques éprouvées. Les résultats viennent d’être publiés dans la revue « Journal of Risk and Financial Management » [1].

La question fondamentale de tout investisseur

Combien en actions, combien en obligations, combien en or ? La répartition entre les classes d’actifs, appelée allocation d’actifs (asset allocation), compte parmi les décisions les plus importantes de toute stratégie de placement. Depuis plus de 70 ans, l’approche de référence est celle issue des travaux du prix Nobel Harry Markowitz. Elle comporte deux étapes : on estime d’abord les rendements et la volatilité attendus de chaque classe d’actifs, ainsi que les interactions entre les placements. On en calcule ensuite le mélange optimal. La faiblesse se situe à la première étape. Les rendements futurs ne peuvent être estimés qu’avec une précision limitée, et même de petites erreurs d’estimation peuvent conduire à des portefeuilles fortement biaisés, sans que cela soit visible au premier coup d’œil.

L’idée : apprendre directement de l’expérience

L’équipe de recherche, composée du Dr Simon Broda (Institut des services financiers de Zoug IFZ de la Haute école de Lucerne), du Prof. Dr Gianluca De Nard (Université du Liechtenstein et Université de Zurich) et du Dr Patrick Walker (OLZ AG et Université de Zurich), a choisi une autre voie. Son modèle repose sur une approche simple issue du reinforcement learning (apprentissage par renforcement). Ici, un programme informatique n’apprend pas à partir de solutions prédéfinies, mais à partir des résultats de ses propres décisions : il teste des répartitions sur des données historiques, reçoit en retour une évaluation de la qualité de l’équilibre entre rendement et risque, et adapte son comportement pas à pas.

La différence avec l’approche classique peut être illustrée par une question simple. L’approche classique demande : quel rendement l’or procurera-t-il l’an prochain ? Le nouveau modèle demande : lorsque les taux montent et que les marchés sont nerveux, quel mélange a fait ses preuves dans de telles situations ? Le détour par la prévision, source d’erreurs, disparaît.

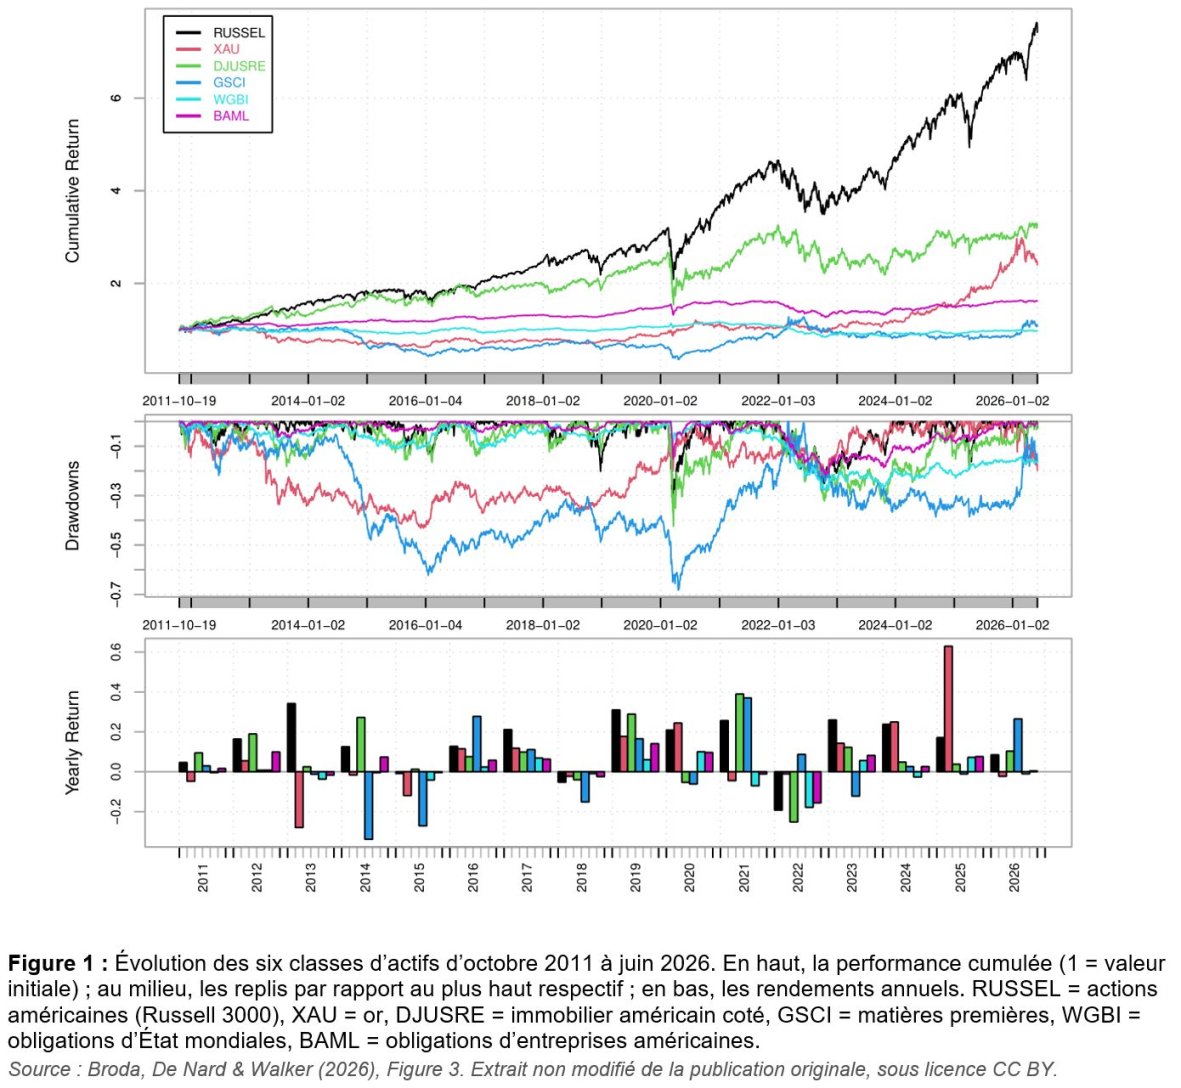
Le modèle s’appuie sur l’évolution des cours et les caractéristiques de risque des classes d’actifs, ainsi que sur des indicateurs économiques tels que les taux d’intérêt, l’inflation, le chômage ou la volatilité des marchés. Il en déduit une nouvelle répartition une fois par mois. L’étude porte sur six classes d’actifs larges, à dominante américaine, qui peuvent toutes être répliquées à moindre coût au moyen de fonds indiciels cotés (ETF) : actions, or, immobilier coté, matières premières, obligations d’État et obligations d’entreprises (figure 1).

Pourquoi une approche simple suffit

Le reinforcement learning s’est fait connaître grâce à des programmes qui maîtrisent les échecs ou le go. Ces systèmes sont complexes, car chaque coup modifie la suite de la partie. Sur les marchés financiers, il en va autrement : un investisseur dont le volume de transactions est faible par rapport au marché n’influence pas les cours. Sa décision d’aujourd’hui ne modifie donc pas la situation de départ de demain. Les chercheurs en tirent parti et traitent chaque mois comme une décision indépendante. Le modèle se passe ainsi de la lourde mécanique des systèmes habituels de reinforcement learning et peut être entraîné de manière légère et rapide.

À cela s’ajoute une seconde astuce : le modèle ne part pas de zéro, mais de la solution classique de Markowitz, qu’il cherche à améliorer progressivement à l’aide des données.
Ce que montre le test sur plus de 14 ans

Le modèle a été testé rétrospectivement d’octobre 2011 à juin 2026, de telle sorte qu’il ne connaissait à chaque instant que les données de cours et les données économiques réellement disponibles à l’époque. Il a été comparé au portefeuille classique de Markowitz et à un portefeuille simple à pondération égale.

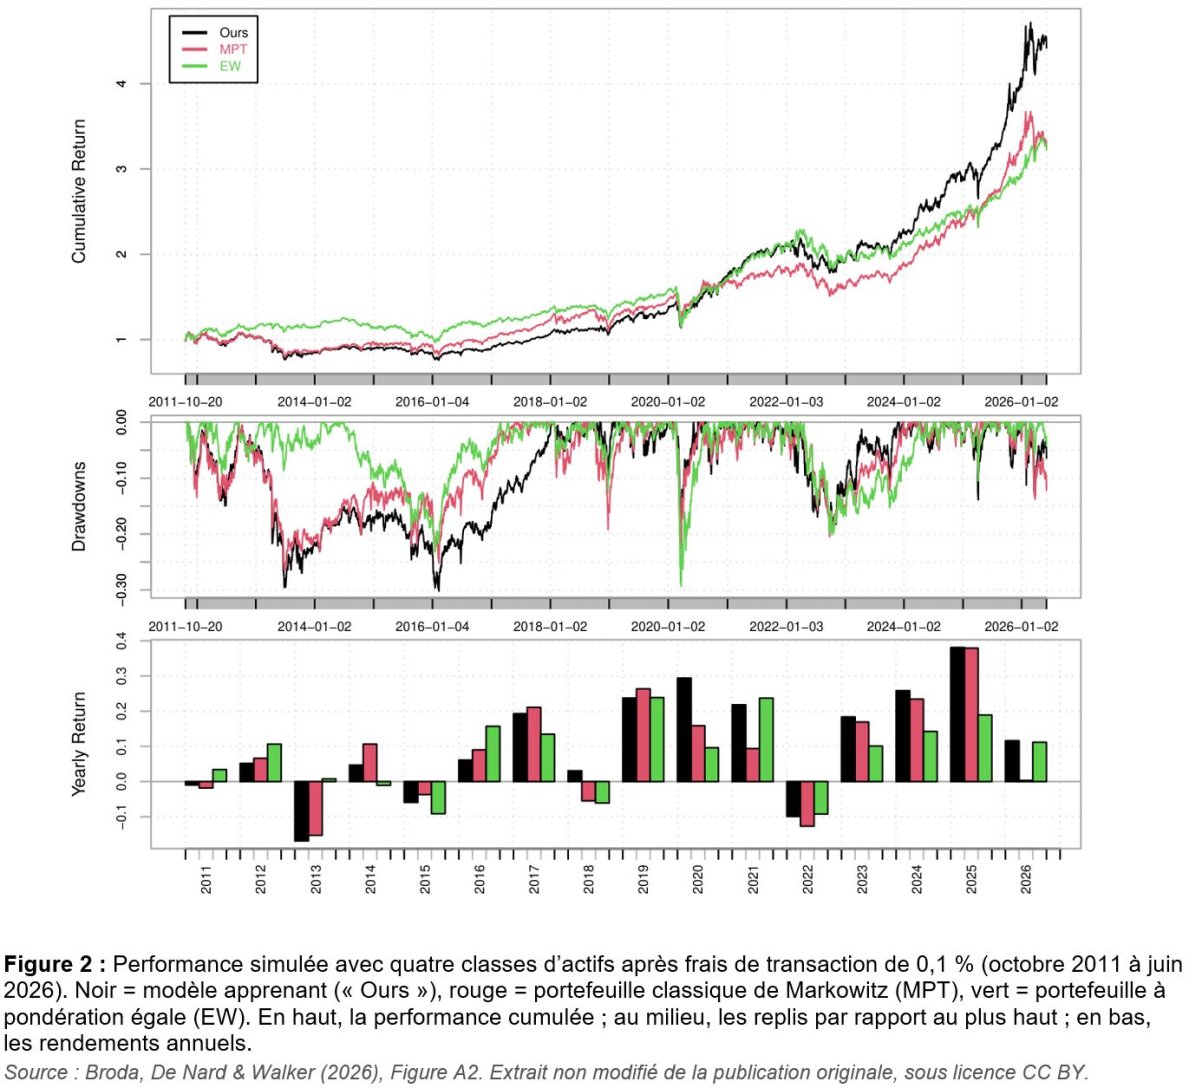
Avec quatre classes d’actifs (actions, or, immobilier, matières premières), le modèle apprenant a obtenu, avant coûts, un rendement total d’environ 374 %. Avec une mise de 100 unités, on aurait donc obtenu environ 474. Le portefeuille de Markowitz a atteint 235 %, le portefeuille à pondération égale 222 %. Après déduction de frais de transaction de 0,1 % du volume échangé, l’avance est restée intacte : 342 % contre 228 et 220 % (figure 2). Avec les six classes d’actifs, donc obligations comprises, le modèle a réalisé 336 % après coûts, contre 199 % pour le portefeuille de Markowitz et 138 % pour le portefeuille à pondération égale.

La manière de procéder du modèle est instructive (figure 3). Il a réalloué nettement plus souvent et plus fortement que le portefeuille de Markowitz, surtout entre actions et or. Selon l’étude, l’avance obtenue avec quatre classes d’actifs provient d’ailleurs principalement de ce timing. Lors de la chute des marchés au printemps 2020, le modèle s’est replié presque entièrement sur l’or avant de revenir rapidement aux actions. Lors de la hausse des taux de 2022, il a réduit les actions au profit de l’or et ne détenait pratiquement plus d’immobilier, sensible aux taux. Lorsque des obligations sont également disponibles, le modèle n’en détient que peu, alors que le portefeuille classique de Markowitz était majoritairement investi en obligations d’entreprises jusqu’en 2022.

Mise en perspective

Les résultats reposent sur une simulation rétrospective portant sur une seule période historique et sur des marchés majoritairement américains. L’avance de rendement sur le portefeuille de Markowitz est économiquement importante, mais une grande partie s’est constituée après le point bas lié au coronavirus de mars 2020. Le modèle effectue en outre nettement plus de transactions. Avec six classes d’actifs, il fluctue davantage que le portefeuille de Markowitz, fortement pondéré en obligations, qui atteint ici le meilleur rapport rendement/risque. Avec des plafonds par classe d’actifs, comme il est d’usage en pratique, l’avance tend à être plus faible. Lors de l’entraînement du modèle, un problème tenait en outre au fait que, selon le choix du « random seed » (graine aléatoire), il recommande des allocations sensiblement différentes ; c’est pourquoi le modèle final calcule son allocation en faisant la moyenne sur un grand nombre de graines aléatoires différentes. Cette astuce a permis d’obtenir des allocations nettement plus robustes dans le temps.

Conclusion

L’étude montre qu’une approche de reinforcement learning relativement simple peut rivaliser avec les outils qui font référence en gestion de fortune depuis des décennies, et qu’elle les a parfois nettement surpassés en termes de rendement sur la période étudiée. Elle montre toutefois tout aussi clairement où se situent les limites. En matière de placement, l’intelligence artificielle n’est pas une baguette magique, mais un outil qui doit être soigneusement testé, compris et contrôlé.

Source

[1] Broda, S. A., De Nard, G., & Walker, P. (2026). Dynamic Asset Allocation with Direct Policy Optimization: Evidence from a US Public-Market Multi-Asset Universe. Journal of Risk and Financial Management, 19(11), 855. https://doi.org/10.3390/jrfm19110855

La publication est en libre accès (open access) et placée sous licence Creative Commons Attribution (CC BY). Les figures 1 à 3 sont des extraits de la publication originale ; pour la figure 3, les deux graphiques partiels ont été disposés côte à côte, les graphiques étant par ailleurs inchangés. Les légendes des figures ont été rédigées pour cet article. Le projet de recherche a été soutenu par Innosuisse (n° de projet 102.048 IP-SBM). Patrick Walker est employé d’OLZ AG ; Gianluca De Nard a travaillé chez OLZ AG pendant la majeure partie de la durée du projet. Cet article est publié à titre d’information uniquement et ne constitue ni un conseil en placement ni une offre. Les résultats présentés reposent sur des simulations historiques. Les performances passées ne constituent pas un indicateur fiable des résultats futurs.

Nous sommes toujours heureux de parler avec vous.

Un lien durable avec nos clients est plus important pour nous que le simple succès. N'hésitez pas à nous contacter, nous nous en réjouissons. Ou contactez-nous directement: