13. November 2026
5 Minuten

Wenn die Maschine lernt, eine Asset-Allokation zu steuern: Reinforcement Learning in der Vermögensanlage

In einem von Innosuisse geförderten Innovationsprojekt haben die OLZ AG und die Hochschule Luzern untersucht, ob ein lernendes Computermodell ein Portfolio besser auf verschiedene Anlageklassen aufteilen kann als bewährte klassische Verfahren. Die Ergebnisse sind nun in der Fachzeitschrift «Journal of Risk and Financial Management» erschienen [1].

Die Grundfrage jedes Anlegers

Wie viel in Aktien, wie viel in Obligationen, wie viel in Gold? Die Aufteilung auf Anlageklassen, die sogenannte Asset Allocation, gehört zu den wichtigsten Entscheiden jeder Anlagestrategie. Seit über 70 Jahren gilt dafür ein Ansatz als Standard, der auf den Nobelpreisträger Harry Markowitz zurückgeht. Er verlangt zwei Schritte: Zuerst wird geschätzt, welche Renditen und Schwankungen von jeder Anlageklasse zu erwarten sind und wie sich die Anlagen gegenseitig beeinflussen. Daraus wird dann die optimale Mischung berechnet. Die Schwäche liegt im ersten Schritt. Zukünftige Renditen lassen sich nur ungenau schätzen, und schon kleine Schätzfehler können zu stark verzerrten Portfolios führen, ohne dass dies auf den ersten Blick sichtbar wäre.

Die Idee: Direkt aus Erfahrung lernen

Das Forschungsteam mit Dr. Simon Broda (Institut für Finanzdienstleistungen Zug IFZ der Hochschule Luzern), Prof. Dr. Gianluca De Nard (Universität Liechtenstein und Universität Zürich) und Dr. Patrick Walker (OLZ AG und Universität Zürich) hat einen anderen Weg gewählt. Ihr Modell ist ein einfacher Ansatz aus dem Reinforcement Learning. Dabei lernt ein Computerprogramm nicht aus vorgegebenen Lösungen, sondern aus den Ergebnissen seiner eigenen Entscheidungen: Es probiert auf historischen Daten Aufteilungen aus, erhält als Rückmeldung, wie gut diese Rendite und Risiko ausbalanciert haben, und passt sein Verhalten Schritt für Schritt an.

Der Unterschied zum klassischen Vorgehen lässt sich an einer einfachen Frage zeigen. Der klassische Ansatz fragt: Welche Rendite wird Gold nächstes Jahr bringen? Das neue Modell fragt: Wenn die Zinsen steigen und die Märkte nervös sind, welche Mischung hat sich in solchen Lagen bewährt? Der fehleranfällige Umweg über die Prognose entfällt.

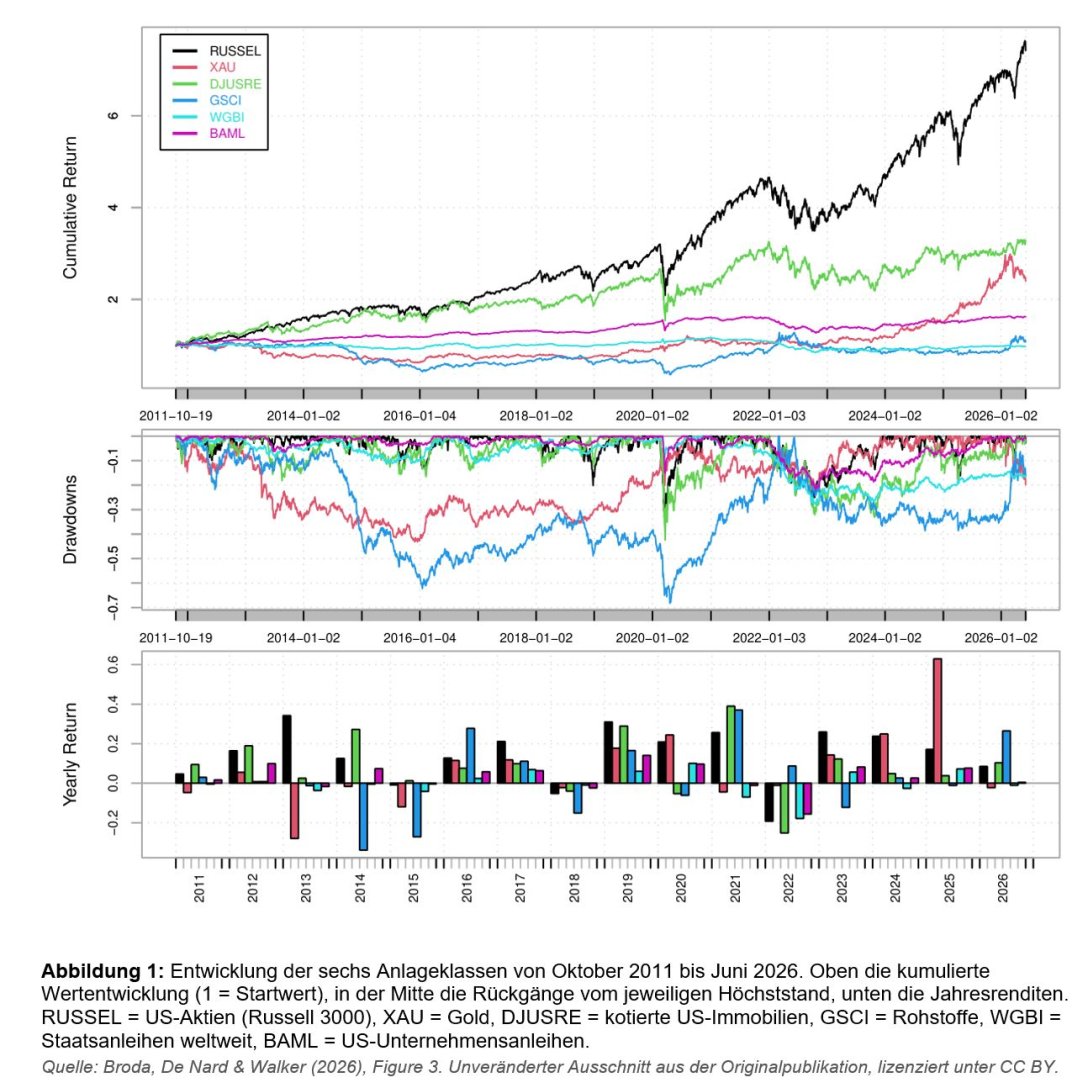
Als Grundlage dienen dem Modell die Kursentwicklung und Risikoeigenschaften der Anlageklassen sowie wirtschaftliche Indikatoren wie Zinsen, Inflation, Arbeitslosigkeit oder die Marktvolatilität. Daraus leitet es einmal pro Monat eine neue Aufteilung ab. Untersucht wurden sechs breite, vorwiegend US-amerikanische Anlageklassen, die sich alle günstig über börsengehandelte Indexfonds (ETFs) abbilden lassen: Aktien, Gold, kotierte Immobilien, Rohstoffe, Staatsanleihen und Unternehmensanleihen (Abbildung 1).

Warum ein einfacher Ansatz genügt

Bekannt geworden ist Reinforcement Learning durch Programme, die Schach oder Go meistern. Solche Systeme sind aufwendig, weil jeder Zug die weitere Partie verändert. An den Finanzmärkten ist das anders: Ein Anleger, dessen Handelsvolumen im Verhältnis zum Markt klein ist, beeinflusst die Kurse nicht. Seine Entscheidung von heute verändert die Ausgangslage von morgen also nicht. Die Forschenden nutzen dies und behandeln jeden Monat als eigenständige Entscheidung. So kommt das Modell ohne die aufwendige Maschinerie üblicher Reinforcement-Learning-Systeme aus und lässt sich schlank und schnell trainieren.

Hinzu kommt ein zweiter Kniff: Das Modell beginnt nicht bei null, sondern startet bei der klassischen Markowitz-Lösung und versucht, diese anhand der Daten schrittweise zu verbessern.
Was der Test über gut 14 Jahre zeigt

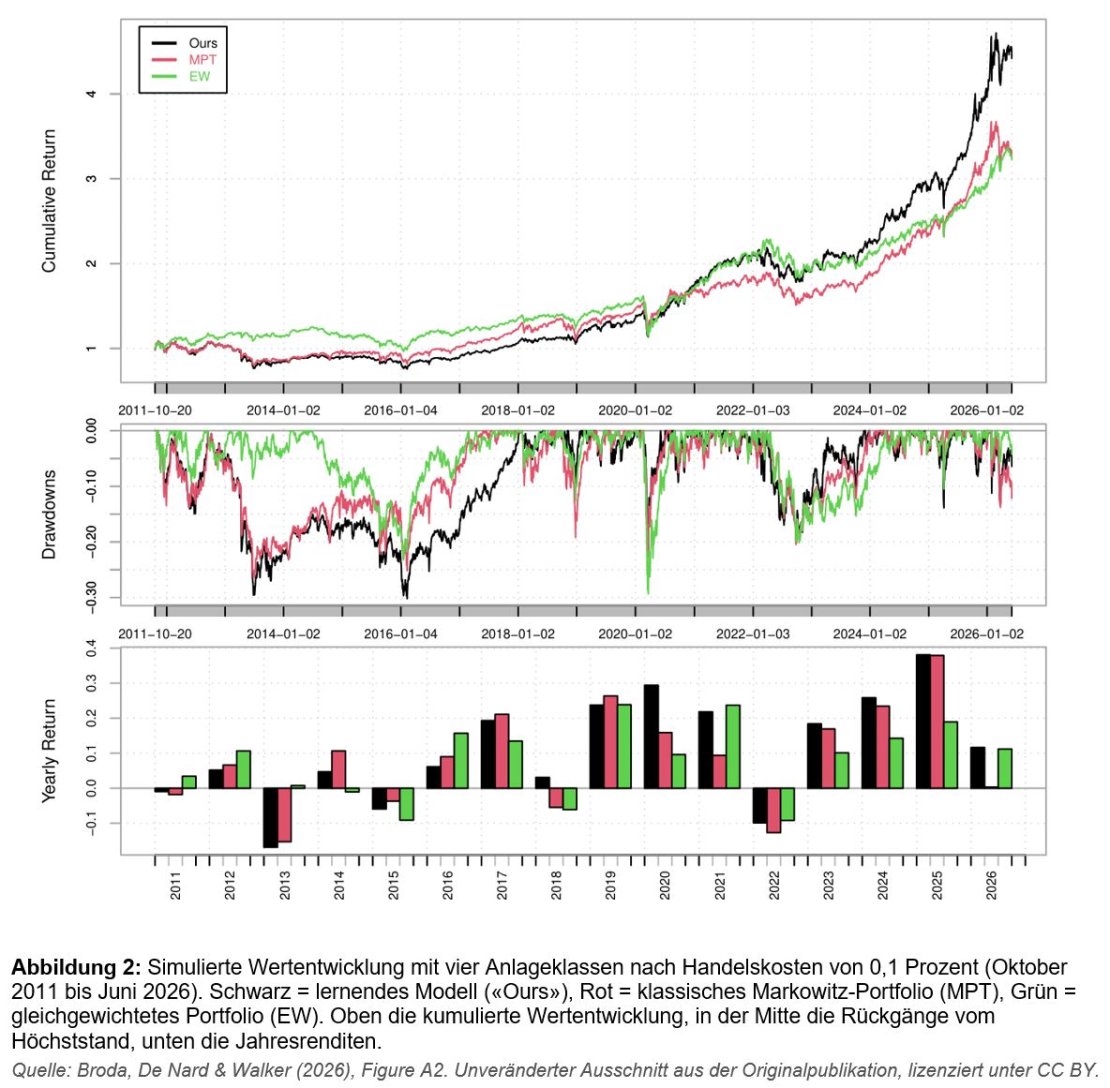
Das Modell wurde von Oktober 2011 bis Juni 2026 rückwirkend getestet, und zwar so, dass es zu jedem Zeitpunkt nur Kurs- und Wirtschaftsdaten kannte, die damals tatsächlich verfügbar waren. Verglichen wurde es mit dem klassischen Markowitz-Portfolio und einem einfachen, gleichgewichteten Portfolio.

Mit vier Anlageklassen (Aktien, Gold, Immobilien, Rohstoffe) erzielte das lernende Modell vor Kosten eine Gesamtrendite von rund 374 Prozent. Aus 100 Einheiten wären also rund 474 geworden. Das Markowitz-Portfolio kam auf 235 Prozent, das gleichgewichtete auf 222 Prozent. Nach Abzug von Handelskosten von 0,1 Prozent des gehandelten Volumens blieb der Vorsprung bestehen: 342 Prozent gegenüber 228 und 220 Prozent (Abbildung 2). Mit allen sechs Anlageklassen, also einschliesslich Obligationen, erzielte das Modell nach Kosten 336 Prozent, gegenüber 199 Prozent für das Markowitz-Portfolio und 138 Prozent für das gleichgewichtete Portfolio.

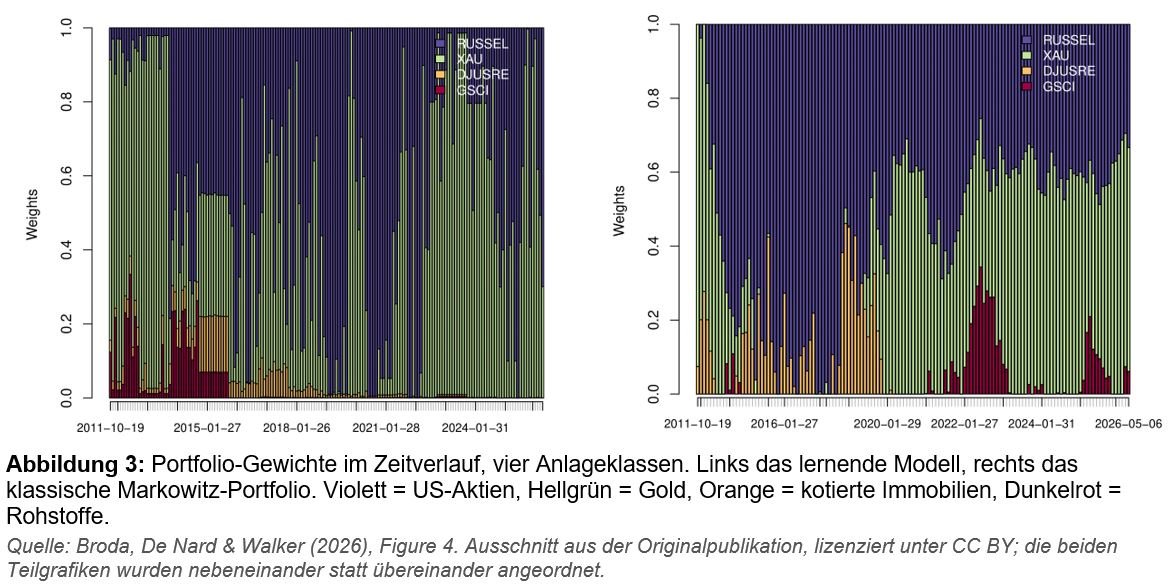
Aufschlussreich ist, wie das Modell vorging (Abbildung 3). Es schichtete deutlich häufiger und stärker um als das Markowitz-Portfolio, vor allem zwischen Aktien und Gold. Gemäss der Studie stammt der Vorsprung mit vier Anlageklassen denn auch hauptsächlich aus diesem Timing. Beim Markteinbruch im Frühling 2020 wechselte das Modell fast vollständig in Gold und kehrte danach rasch in Aktien zurück. Im Zinsanstieg von 2022 reduzierte es Aktien zugunsten von Gold und hielt praktisch keine zinsempfindlichen Immobilien mehr. Stehen auch Obligationen zur Auswahl, hält das Modell davon nur wenig, während das klassische Markowitz-Portfolio bis 2022 mehrheitlich in Unternehmensanleihen investiert war.

Einordnung

Die Ergebnisse beruhen auf einer rückblickenden Simulation über einen einzigen historischen Zeitraum und vorwiegend US-amerikanische Märkte. Der Renditevorsprung gegenüber dem Markowitz-Portfolio ist wirtschaftlich gross, aber ein grosser Teil davon entstand nach dem Corona-Tiefpunkt im März 2020. Das Modell handelt zudem deutlich häufiger. Mit sechs Anlageklassen schwankt es stärker als das obligationenlastige Markowitz-Portfolio, das dort das bessere Verhältnis von Rendite zu Risiko erreicht. Mit Obergrenzen pro Anlageklasse, wie sie in der Praxis üblich sind, fällt der Vorsprung eher kleiner aus. Ein Problem beim Training des Modells war zudem, dass es je nach Wahl des «Random-Seeds» deutlich unterschiedliche Allokationen empfiehlt, weshalb das finale Modell als Allokation eine Durchschnittsbildung über eine Vielzahl verschiedener Random-Seeds vornimmt. Dieser Trick ermöglichte es deutlich robustere Allokationen im Zeitverlauf zu erzielen.

Fazit

Die Studie zeigt, dass ein vergleichsweise einfacher Reinforcement-Learning-Ansatz mit den Werkzeugen mithalten kann, die in der Vermögensverwaltung seit Jahrzehnten Standard sind, und diese im untersuchten Zeitraum bei der Rendite teils deutlich übertroffen hat. Sie zeigt aber ebenso klar, wo die Grenzen liegen. Künstliche Intelligenz ist in der Anlage kein Zauberstab, sondern ein Werkzeug, das sorgfältig geprüft, verstanden und kontrolliert werden muss.

Quelle

[1] Broda, S. A., De Nard, G., & Walker, P. (2026). Dynamic Asset Allocation with Direct Policy Optimization: Evidence from a US Public-Market Multi-Asset Universe. Journal of Risk and Financial Management, 19(11), 855. https://doi.org/10.3390/jrfm19110855

Die Publikation ist frei zugänglich (Open Access) und steht unter der Lizenz Creative Commons Attribution (CC BY). Die Abbildungen 1 bis 3 sind Ausschnitte aus der Originalpublikation; bei Abbildung 3 wurden die beiden Teilgrafiken nebeneinander angeordnet, ansonsten sind die Grafiken unverändert. Die deutschen Bildlegenden wurden für diesen Beitrag verfasst. Das Forschungsprojekt wurde von Innosuisse gefördert (Projekt-Nr. 102.048 IP-SBM). Patrick Walker ist bei der OLZ AG angestellt; Gianluca De Nard war während eines Grossteils der Projektdauer bei der OLZ AG tätig. Dieser Beitrag dient ausschliesslich der Information und stellt weder eine Anlageberatung noch ein Angebot dar. Die dargestellten Ergebnisse beruhen auf historischen Simulationen. Vergangene Wertentwicklungen sind kein verlässlicher Indikator für künftige Ergebnisse.

Wir freuen uns immer, mit Ihnen zu sprechen.

Eine nachhaltige Bindung mit unseren Kunden ist uns mehr wert, als der kurzfristige Erfolg. Treten Sie mit uns in Kontakt, wie freuen uns. Oder kontaktieren Sie uns direkt: